AI Infrastructure2026-09-15 IEEE Spectrum AI
Jalapeño: OpenAI designt Chip mit eigenen LLMs
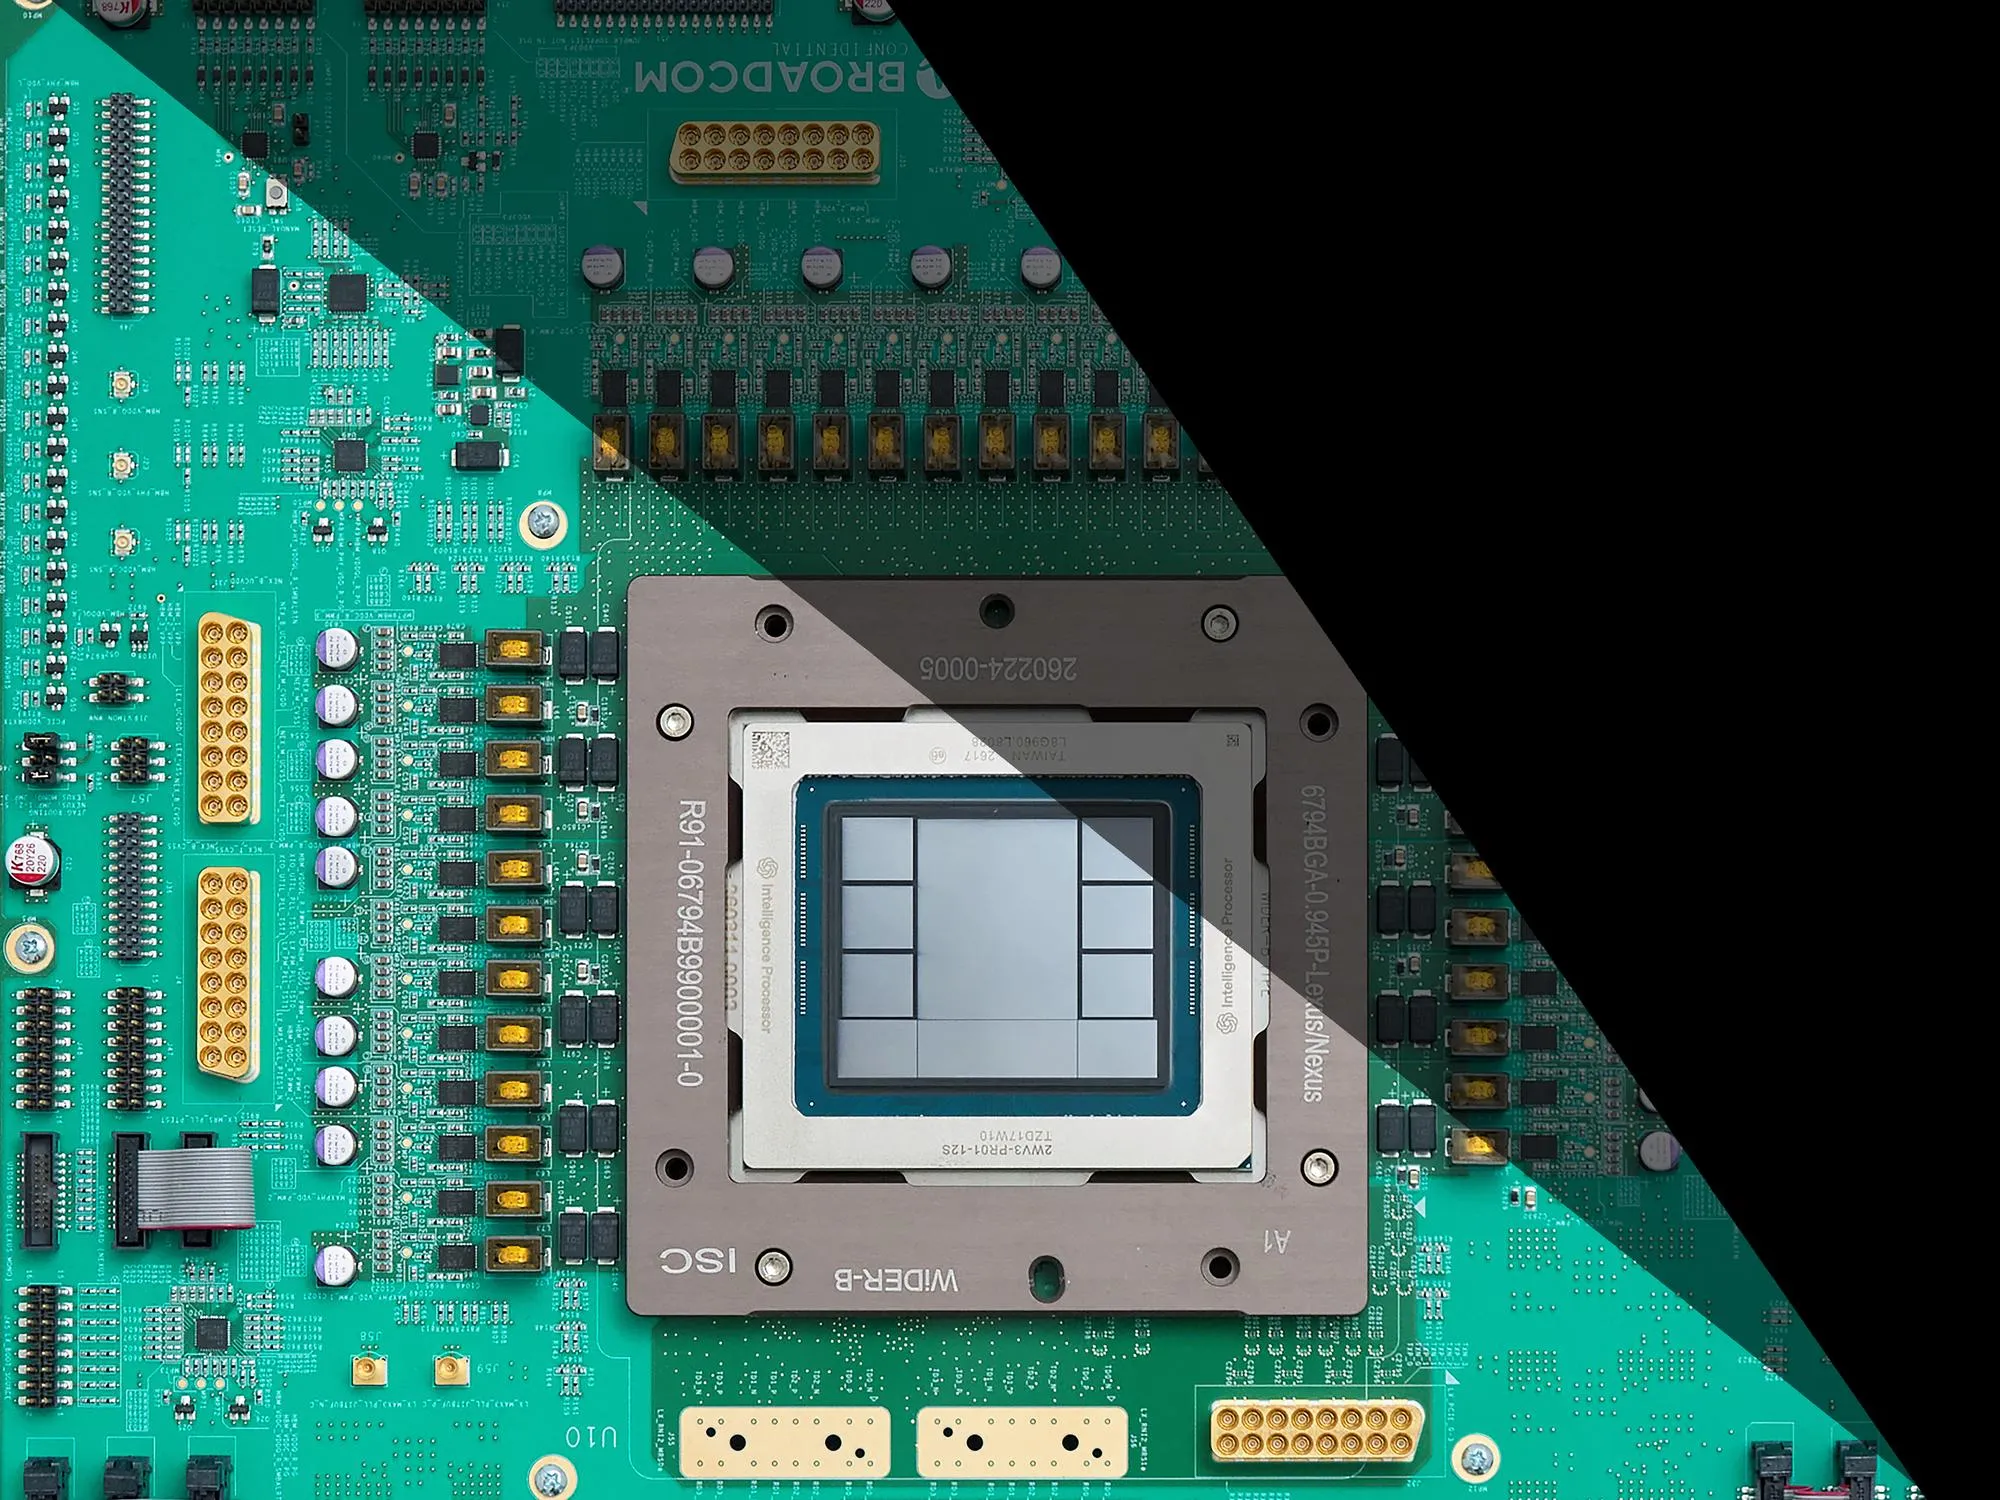
OpenAI hat bekannt gegeben, dass sein erster eigener KI-Beschleuniger mit dem Codenamen Jalapeño maßgeblich mit Hilfe der eigenen Large Language Models entworfen wurde. Der Chip ist für anspruchsvolle KI-Workloads gebaut und bietet bis zu 13,4 Petaflops 4-Bit-Rechenleistung. Hinzu kommen 232 GB moderner Speicher mit einer Bandbreite von 15,4 TB/s. Laut den von OpenAI hervorgehobenen Benchmarks liefert die Hardware starke Leistung – das Projekt ist also mehr als ein symbolisches Experiment.
Die spannendere Geschichte ist jedoch, wie der Chip entstanden ist. OpenAI zufolge haben LLMs zum Engineering-Prozess beigetragen. Das zeigt, dass KI-Systeme bei komplexen Hardware-Designaufgaben unterstützen können, die traditionell große Teams, lange Zeitpläne und teure Iterationsschleifen erfordern. Lässt sich der Ansatz skalieren, könnte er Zeit und Kosten für die Entwicklung neuer Chips senken. Das ist relevant, weil KI-Beschleuniger zentral für das Training und den Betrieb moderner Modelle sind und die Nachfrage nach schnellerem, effizienterem Silizium weiter steigt.
Das Projekt deutet außerdem die Möglichkeit an, dass KI die Werkzeuge verbessert, mit denen KI gebaut wird. Es entsteht eine Rückkopplung: Modelle helfen, künftige Hardware zu optimieren, und diese Hardware trainiert dann stärkere Modelle. Jalapeño ist damit nicht nur eine Produktankündigung, sondern ein Signal, dass KI-gestütztes Chipdesign von der Forschungskuriosität in Richtung praktisches Engineering wandert.
Trotzdem werden Fachleute mehr Details sehen wollen: Wie stark wurde das Design tatsächlich von LLMs gesteuert? Wie schlagen sich die Benchmarks im Vergleich zu konkurrierenden Beschleunigern? Und lässt sich die Methode auf andere Chip-Architekturen übertragen? Trotz dieser offenen Punkte markiert der Auftritt für OpenAI einen bemerkenswerten Meilenstein – sowohl in der Halbleiterentwicklung als auch bei selbst verbessernder KI-Infrastruktur.